WebbyLabПроєктиМоніторинг, бізнес-метрики та доступ ШІ-агентів для рітейлера електроніки
Моніторинг і бізнес-метрики
Моніторинг e-commerce платформи Brain: бізнес-метрики, алерти за хвилини й доступ ШІ-агента лише на читання
КЛІЄНТ
Brain — український рітейлер комп’ютерів та електроніки
Промисловість
E-commerce, рітейл, observability, ШІ
Надані послуги
Архітектура рішення
DevOps та інфраструктура
Observability і моніторинг
Бізнес-метрики та алерти
Безпека та керування доступом
Інтеграція ШІ-агентів (MCP)
Технічна підтримка застосунків
Надані послуги
Архітектура рішення
DevOps та інфраструктура
Observability і моніторинг
Бізнес-метрики та алерти
Безпека та керування доступом
Інтеграція ШІ-агентів (MCP)
Технічна підтримка застосунків
Бриф
Brain — український рітейлер комп’ютерів та електроніки з інтернет-магазином і великим каталогом товарів. Раніше WebbyLab уже створив для Brain B2B-портал для дилерів. Платформа працює на чотирьох хмарних серверах: три вебсервери (основний портал, маркетинг, каталогізатор) і робоча база MySQL з Elasticsearch. Замовлення проходять від оформлення до оплати через кількох платіжних провайдерів і вивантажуються в ERP компанії.
Продакшн працював без метрик, централізованих логів і алертів. Для e-commerce бізнесу це означає непомічені втрачені замовлення, тож Brain попросив WebbyLab зробити продакшн видимим: одне місце для серверів, застосунку й бізнес-процесів, алерти, що доходять до потрібної людини, і жодних нових ризиків для продакшену.
Виклик
Ні метрик, ні централізованих логів, ні алертів: про проблеми повідомляли клієнти, ERP і колеги, зазвичай постфактум і без подробиць
Просте питання займало пів години: щоб знайти найважчий за CPU ендпоінт, треба було зайти по SSH на три сервери, вручну розібрати логи й звести результати
Тихі збої: якщо банк відхиляв оплату, замовлення не вивантажувалося в ERP, без помилки, рядка в лозі чи тривоги
Збої тривали тижнями: сповіщення клієнтам стояли в черзі майже 3 тижні, нічна задача непомітно падала щоночі
Рішення щодо потужностей ухвалювали навмання, не відрізняючи навантаження від покупців і від ботів
Моніторинг не мав відкривати нових вхідних портів, мав безпечно читати робочу базу й коштувати значно дешевше за SaaS
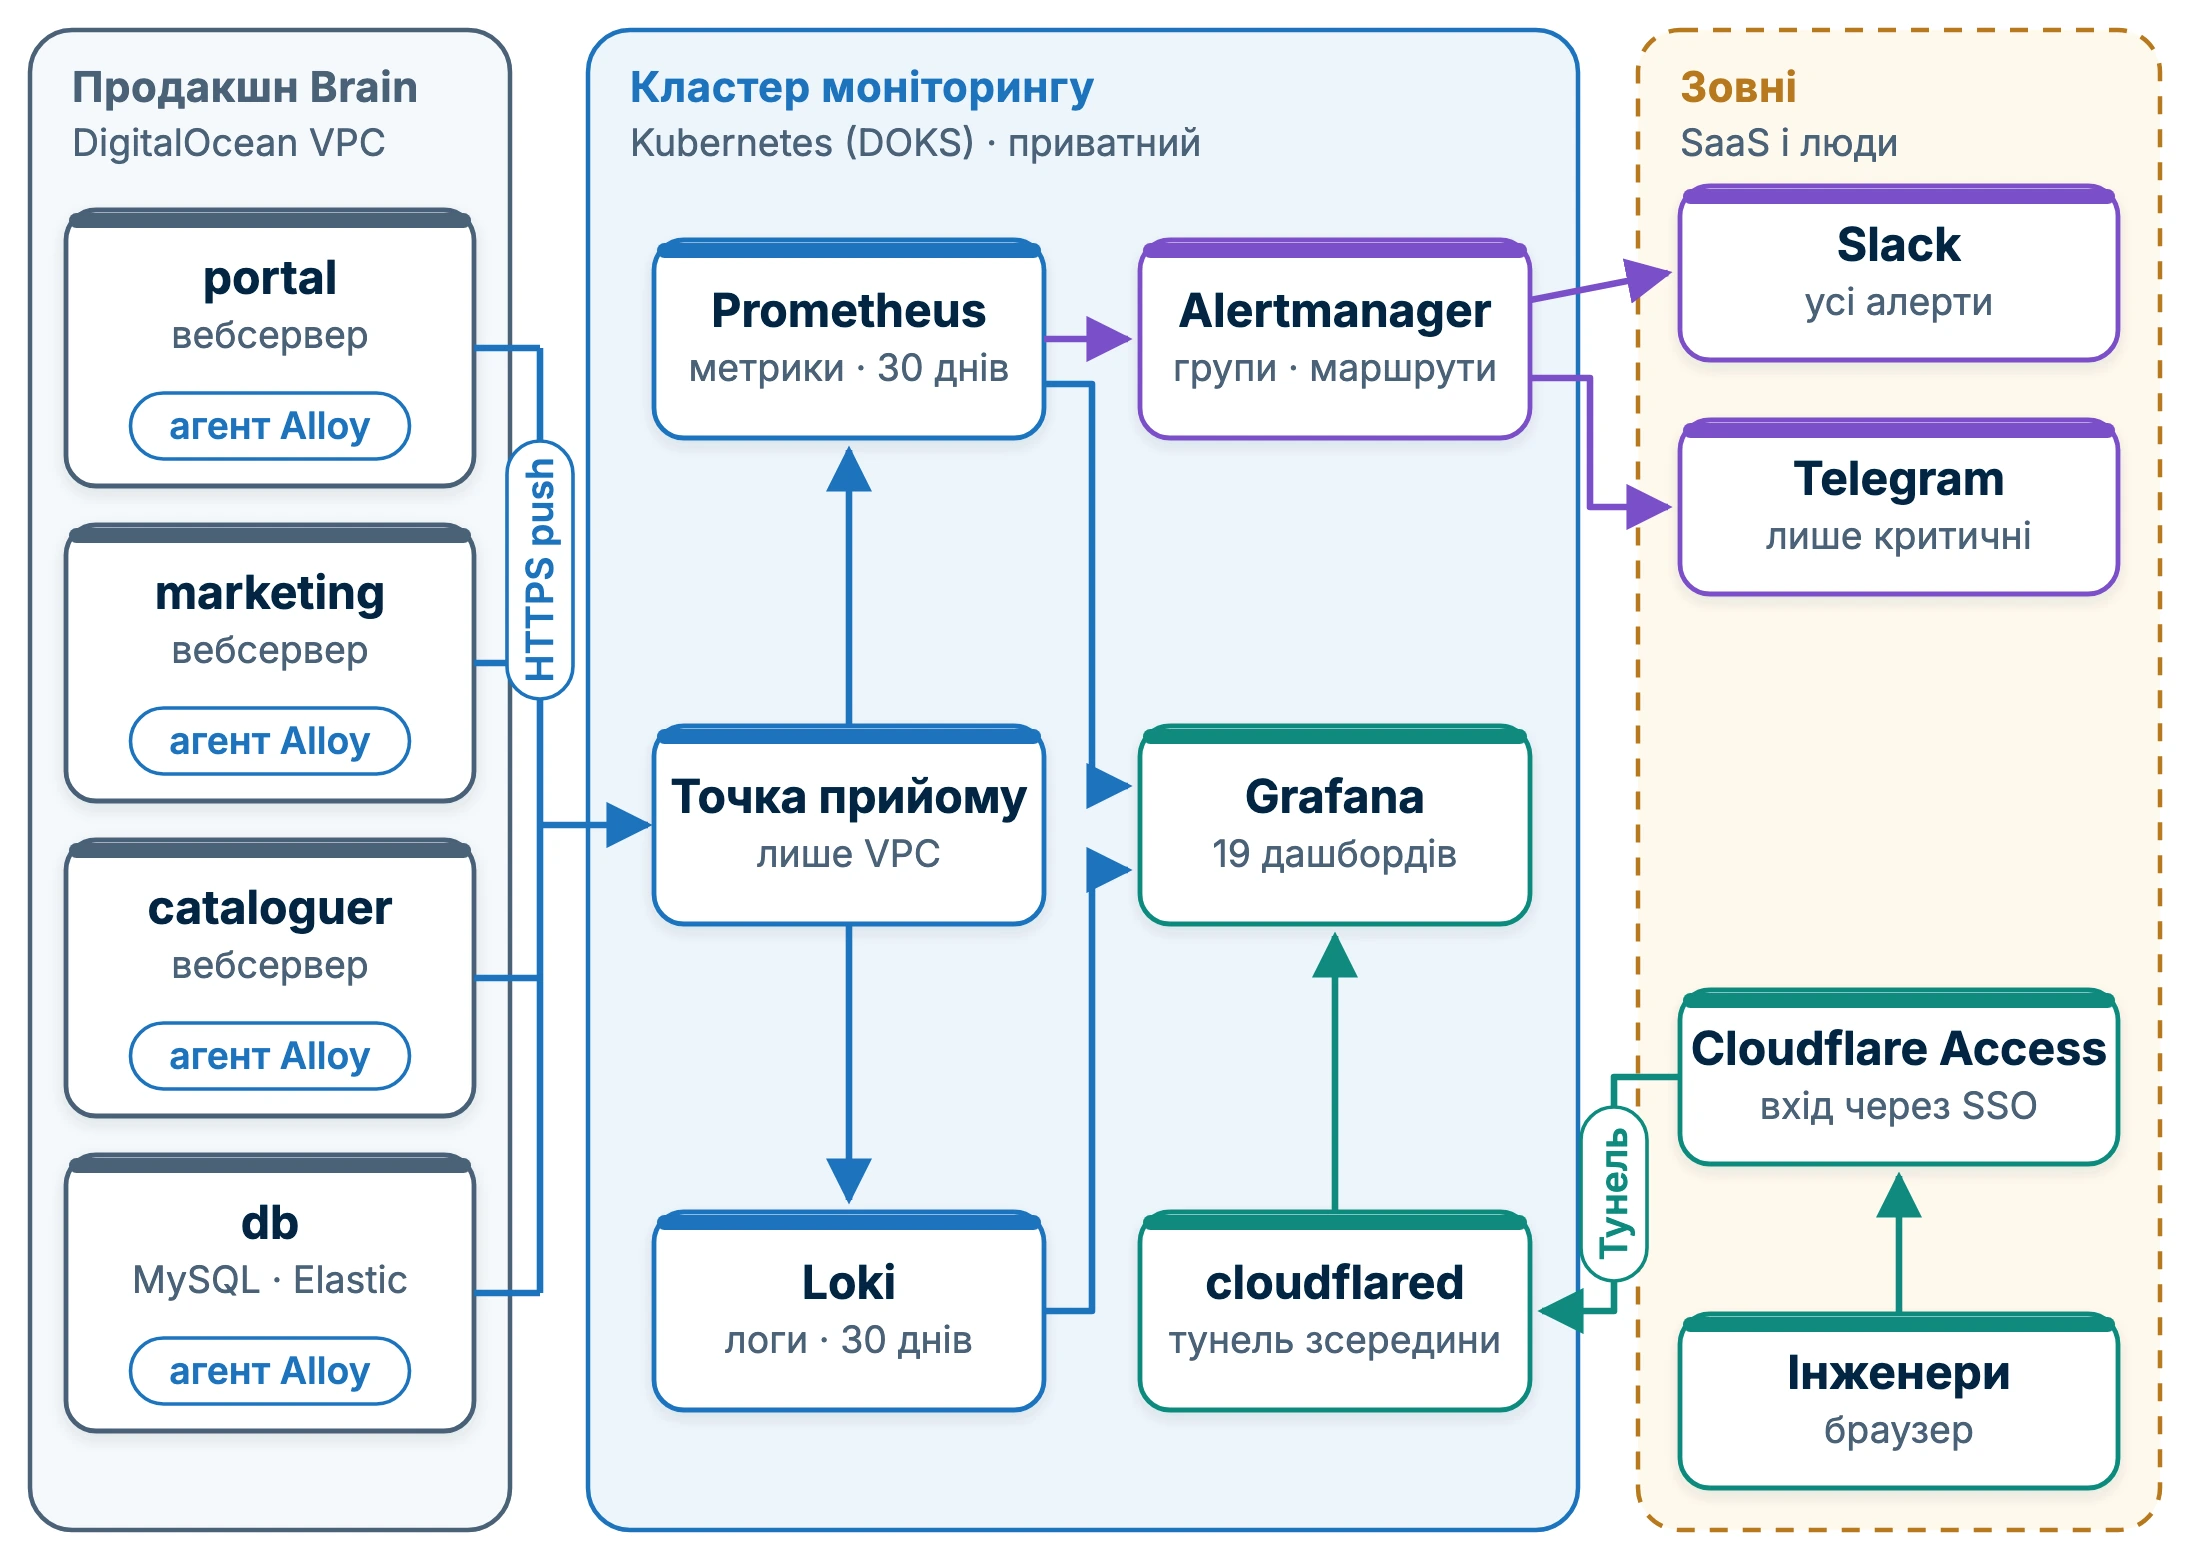
Одне місце для всіх сигналів: сервери надсилають дані в приватний кластер моніторингу; люди й алерти потрапляють туди ззовні.
Огляд рішення
DevOps-команда WebbyLab побудувала стек моніторингу з чотирьох рівнів (інфраструктура, застосунок, бізнес, алерти), додала zero-trust доступ для людей і відкрила ті самі дані ШІ-агентам лише на читання. Усе описано як код у git: Helm, Ansible, рев’ю змін, секрети в SOPS.
Збір даних без нових відкритих портів
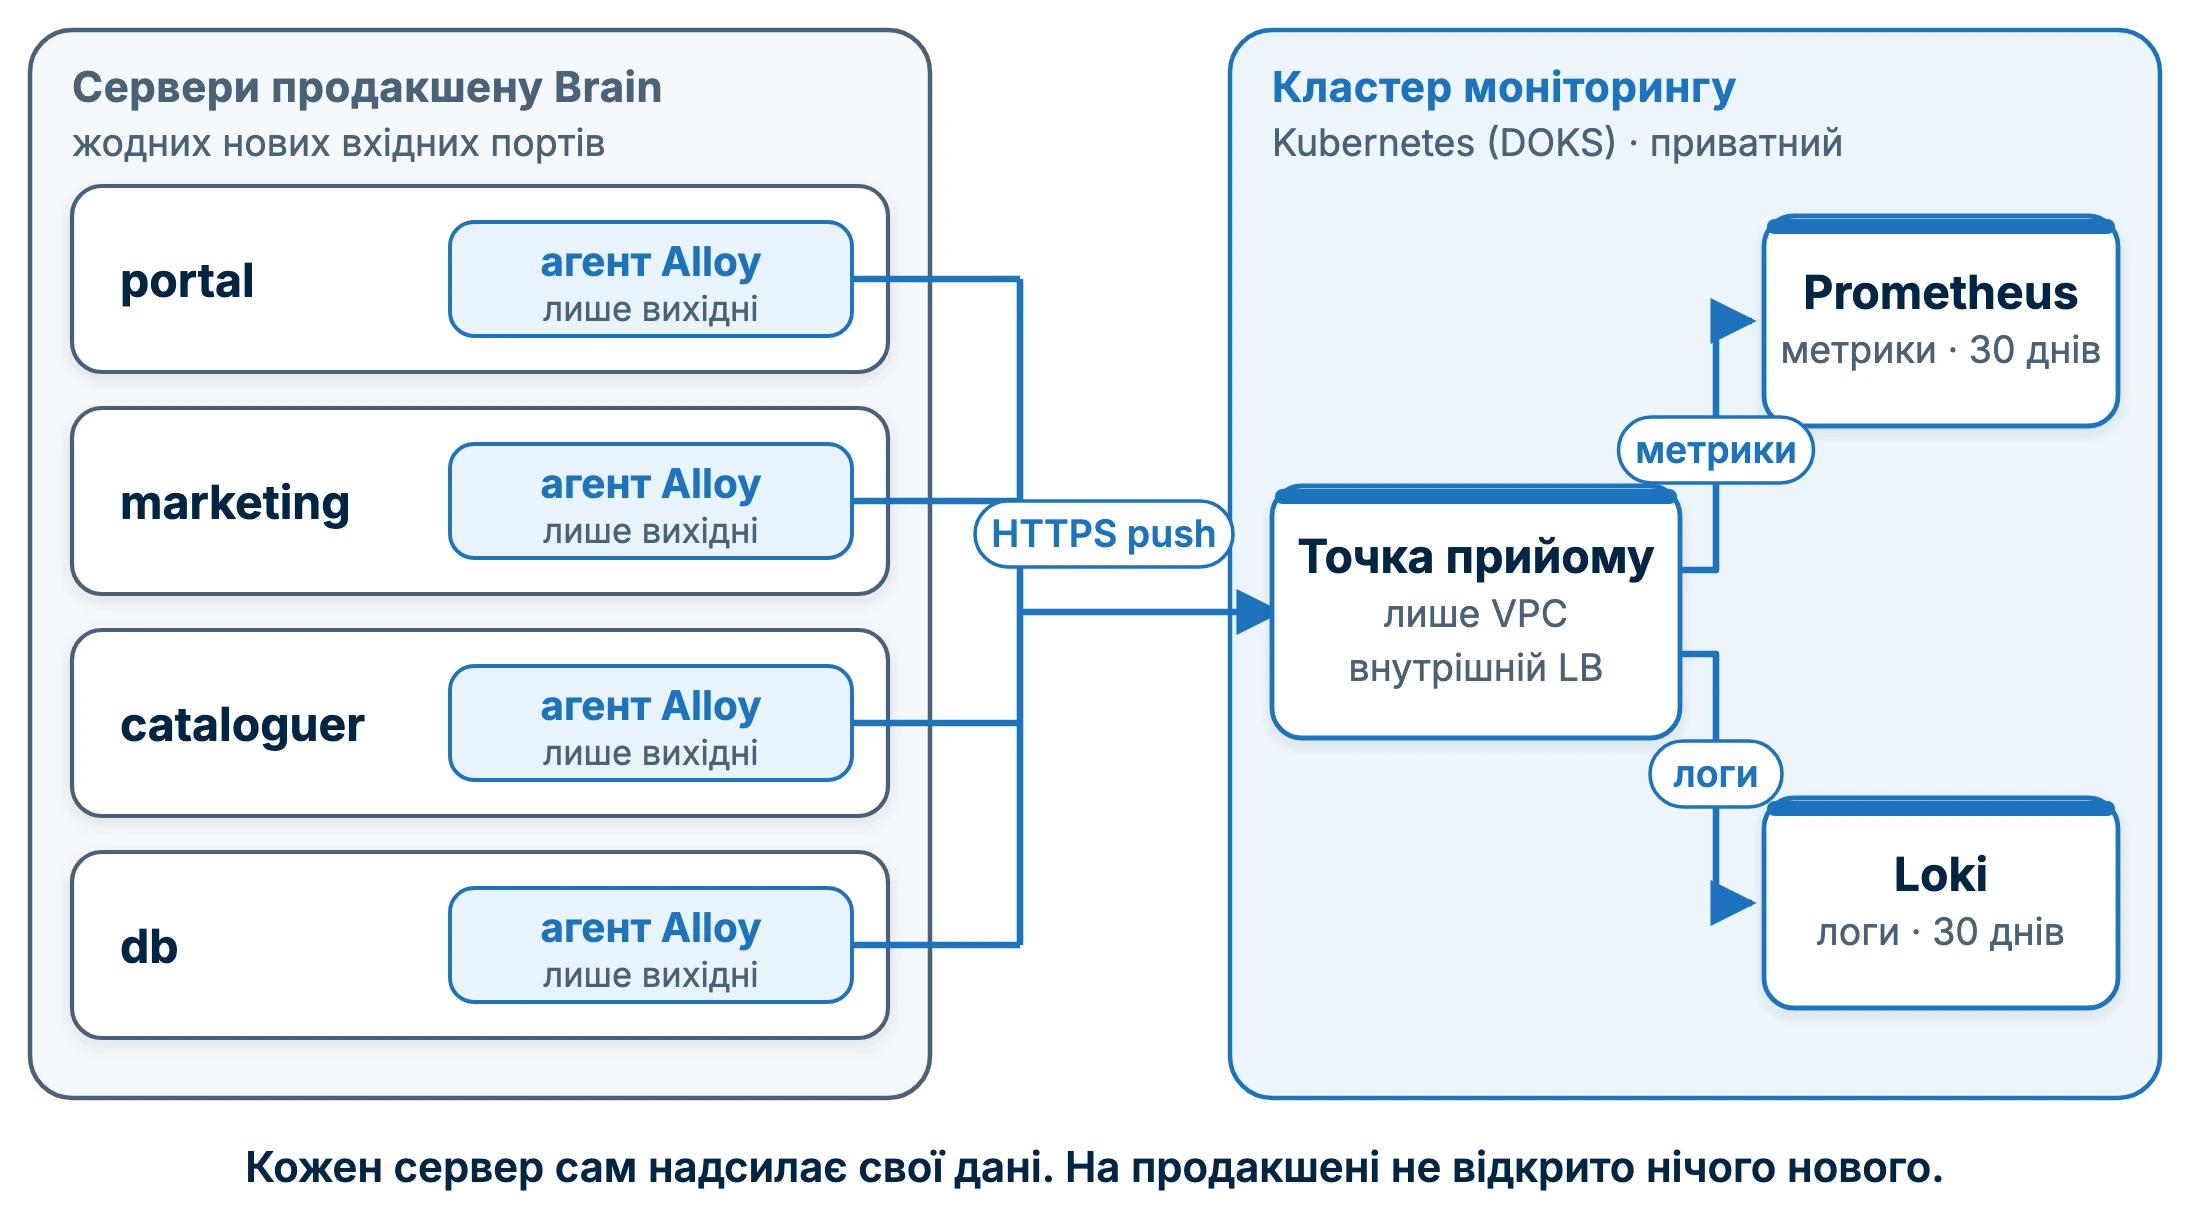
Окремий кластер Kubernetes (DigitalOcean DOKS) у приватній мережі Brain: Prometheus (метрики, 30 днів), Loki (логи, 30 днів), Alertmanager і Grafana. Агент Grafana Alloy на кожному сервері читає наявні метрики, логи й локальні експортери та сам надсилає їх по HTTPS. На продакшені не відкрито нічого нового.
Кожен сервер сам надсилає свої дані; на продакшені не відкрито нічого нового.
CPU і затримки по кожному ендпоінту
Один заголовок відповіді з назвою маршруту і коди завершення cron — єдині зміни в коді Brain. Alloy перетворює логи php-fpm і nginx на метрики CPU і затримок по маршрутах; nginx, PHP-FPM, memcached, MySQL, Elasticsearch, CPU, пам’ять і диски збираються кожні 15 секунд. П’ять пов’язаних панелей Grafana ведуть від симптому до причини.
Бізнес-метрики з робочої бази
SQL-експортер щохвилини читає замовлення, оплати по провайдерах, обмін з ERP, SMS і сповіщення, каталог і прайс-фіди. Кожен запит спершу виміряли на продакшені; запит на 88 секунд переписали. Обмеження: користувач лише з SELECT, ліміт з’єднань, локальний сокет, ліміт часу запитів, фіксований розклад.
Алерти, що доходять до потрібної людини
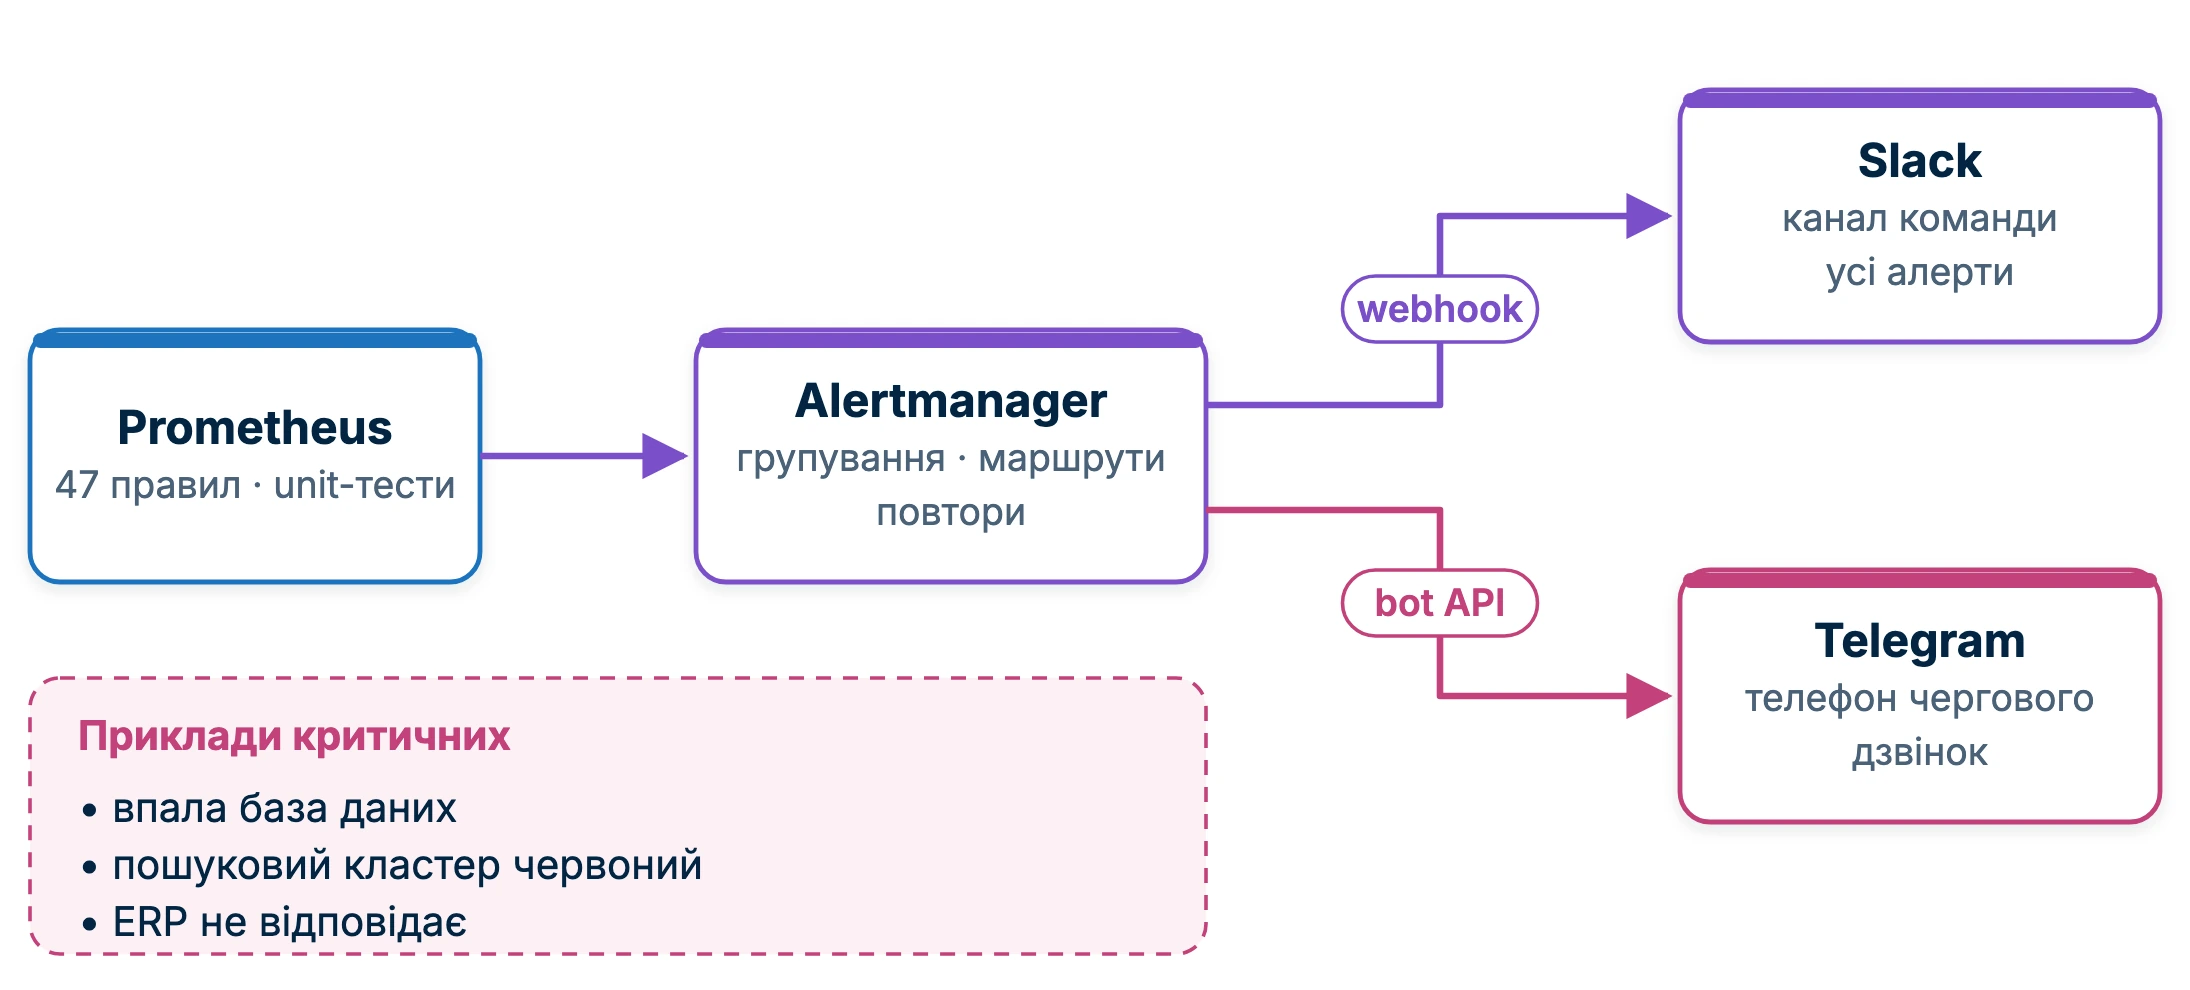
47 правил, які групує й маршрутизує Alertmanager. Усі алерти йдуть у Slack, критичні (впала база, червоний пошуковий кластер, ERP не відповідає) ще й дзвонять у Telegram. Усі правила покриті unit-тестами перед розгортанням, лише для бізнес-правил їх 85.
Кожен алерт іде в Slack; критичні ще й дзвонять на телефон у Telegram.
Zero-trust доступ до дашбордів
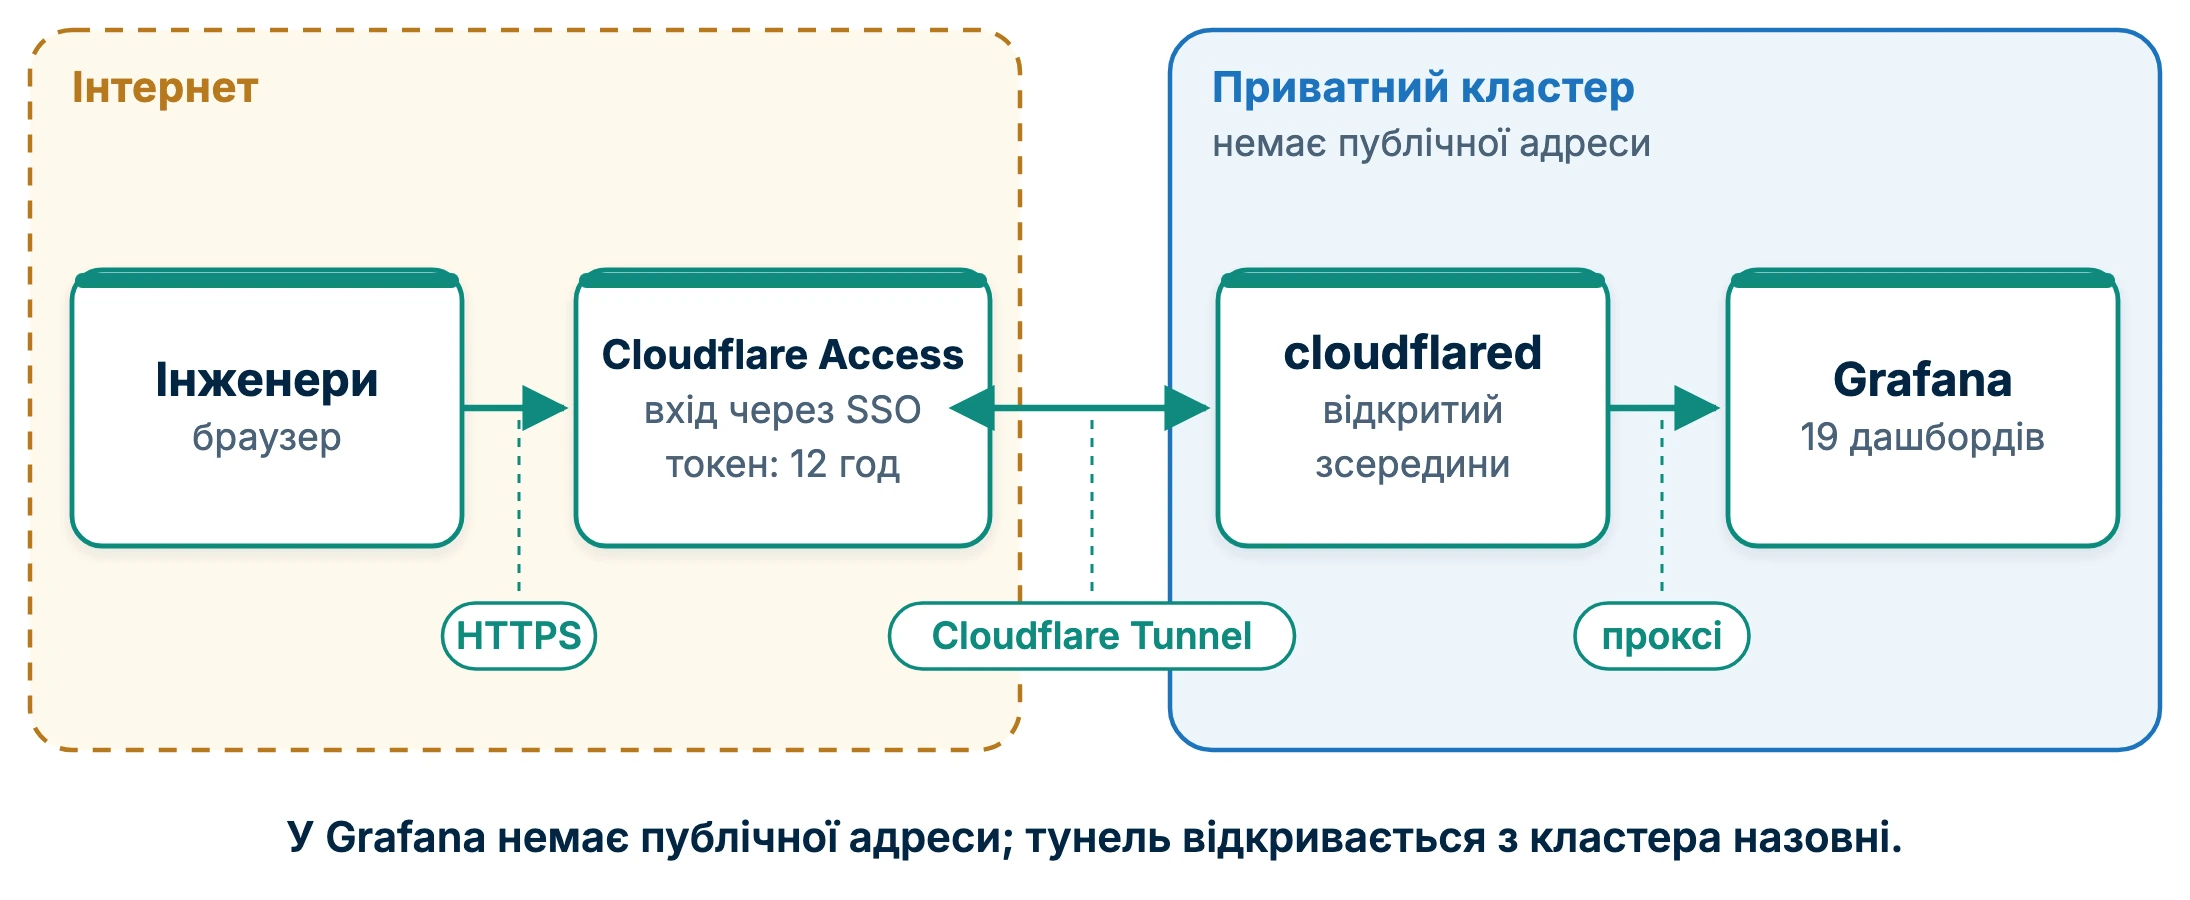
Grafana (19 дашбордів) не має публічної адреси. Інженери входять через Cloudflare Access, а трафік іде тунелем Cloudflare, відкритим зсередини кластера. Особисті токени живуть 12 годин.
Інженери входять через Cloudflare Access; у Grafana немає публічної адреси.
Доступ ШІ-агента лише на читання
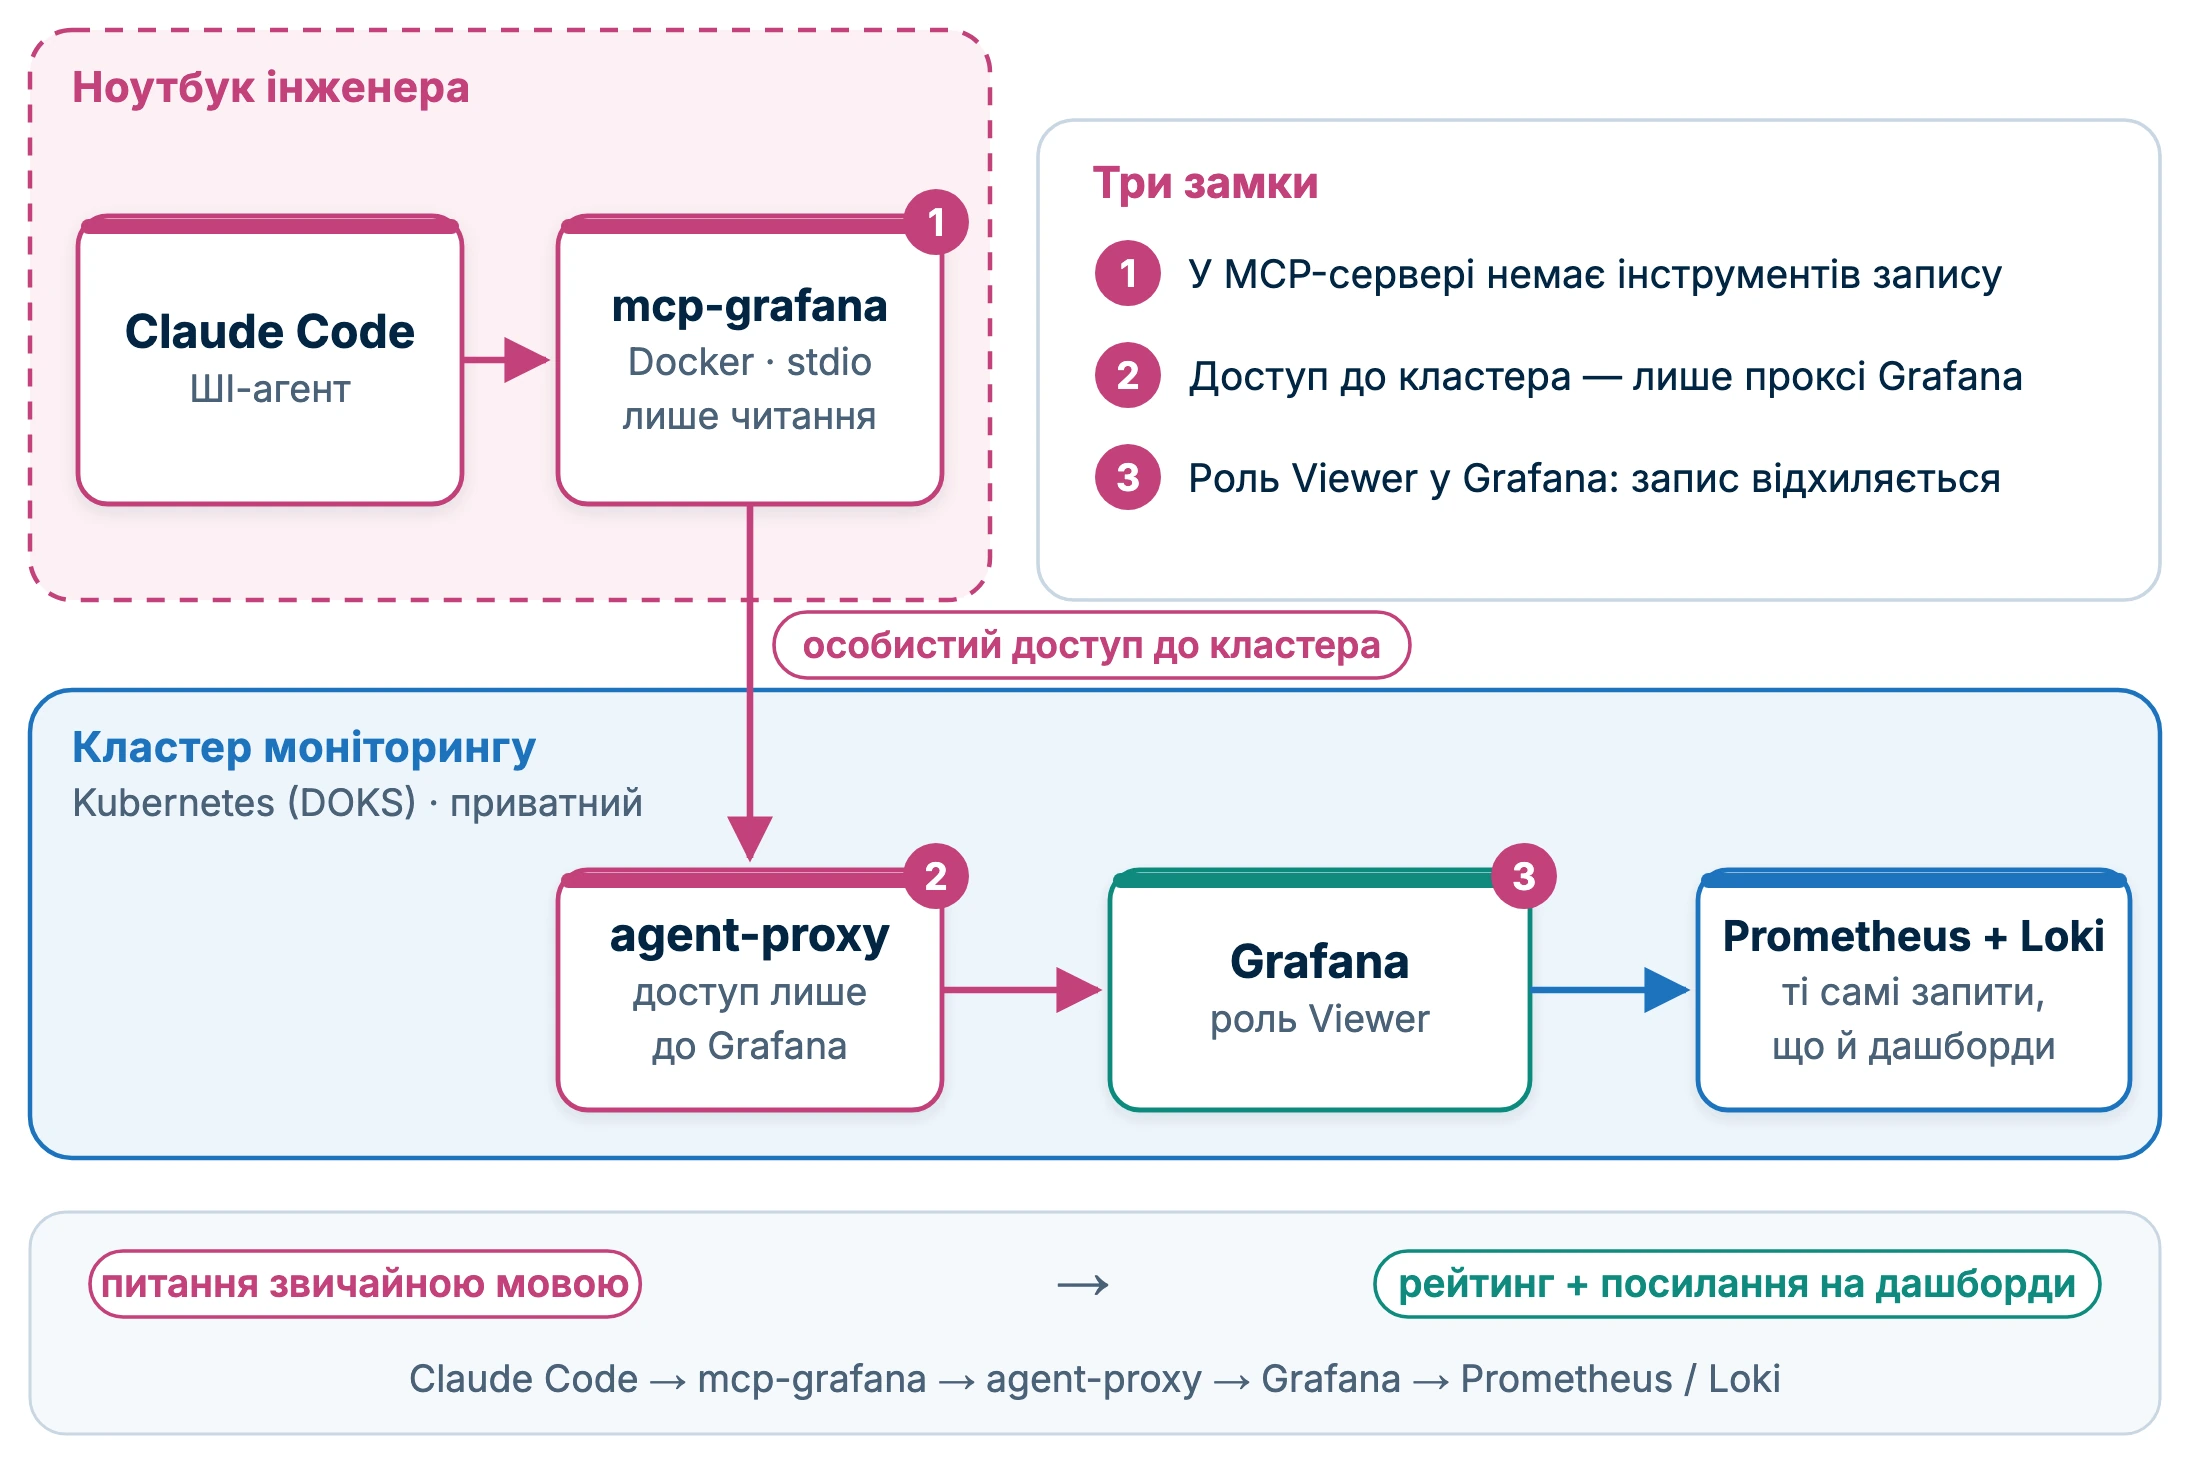
Інженери ставлять питання Claude Code звичайною мовою: той самий підхід WebbyLab використовує в розробці ШІ-агентів. Через MCP-сервер Grafana агент виконує ті самі запити Prometheus і Loki, що й дашборди, і відповідає рейтингом із посиланнями на дашборди. Три замки: немає інструментів запису, особистий доступ до кластера лише до проксі Grafana, роль Viewer у Grafana. Спроби запису відхиляються.
ШІ-агент читає ті самі дані через особисті двері лише на читання.
Ключові результати та цінність
5 тихих збоїв за 48 годин: замовлення, що випадали після відхиленої оплати (~90 на місяць), 12 сповіщень у черзі з вересня, фід відгуків, що перестав оновлюватися, нічна задача, що падала щоночі, і затримки SMS.
Час виявлення: тижні → хвилини: критичні проблеми дзвонять на телефон за 2–30 хвилин, раніше, ніж напише клієнт.
Моніторинг у 6–9 разів дешевший за SaaS: близько $85 на місяць проти орієнтовних $545–770 у SaaS на кшталт Datadog на тих самих обсягах; економія $5,5–8 тис. на рік, дані лишаються в мережі Brain.
Відхилені оплати знову стають продажами: після релізу виправлення кожне замовлення, від якого відмовився банк, потраплятиме до менеджера, і той зможе запропонувати іншу оплату.
Збій релізу виправили того ж вечора: реліз, що поклав сайт на 3 хвилини, діагностували за кілька хвилин і виправили через 39 хвилин.
Збої SMS і ERP дзвонять на телефон: 5-годинний збій SMS, через який замовлення завершили лише 67% покупців, тепер дав би тривогу приблизно за 10 хвилин; тривога ERP на 30 днях історії зловила 3 реальні збої з 3 без жодної хибної.
Каталог свіжий щоранку: нічне оновлення каталогу скоротилося з 50–55 хвилин до 6 і більше не вішає сервер.
Залізо купують за даними: попередження про брак потужностей приходить за тижні, і видно, чи навантаження дають покупці, чи боти.
Відповіді за секунди: питання, що займало пів години на трьох серверах, тепер — одна панель Grafana або одне питання ШІ-агенту.
Експертиза WebbyLab
Архітектура observability: метрики, логи й бізнес-дані в одному приватному та економному стеку
Бізнес-моніторинг: замовлення, оплати й обмін з ERP як метрики та алерти на живій робочій базі
Безпека за замовчуванням: жодних вхідних портів, zero-trust доступ, мінімальні права для бази й агента
Надійні алерти: маршрутизовані, без дублів, покриті тестами й перевірені на історії
Інтеграція ШІ-агентів: MCP-доступ лише на читання для питань про продакшн звичайною мовою
Інфраструктура як код: усе в git, з рев’ю та відтворюване
To provide the best experiences, we use technologies like cookies to store and/or access device information. Consenting to these technologies will allow us to process data such as browsing behavior or unique IDs on this site. Not consenting or withdrawing consent, may adversely affect certain features and functions.
Functional
Always active
The technical storage or access is strictly necessary for the legitimate purpose of enabling the use of a specific service explicitly requested by the subscriber or user, or for the sole purpose of carrying out the transmission of a communication over an electronic communications network.
Preferences
The technical storage or access is necessary for the legitimate purpose of storing preferences that are not requested by the subscriber or user.
Statistics
The technical storage or access that is used exclusively for statistical purposes.The technical storage or access that is used exclusively for anonymous statistical purposes. Without a subpoena, voluntary compliance on the part of your Internet Service Provider, or additional records from a third party, information stored or retrieved for this purpose alone cannot usually be used to identify you.
Marketing
The technical storage or access is required to create user profiles to send advertising, or to track the user on a website or across several websites for similar marketing purposes.